60-DAY BRAND OPERATING PROGRAM · WEEK 03
발행한 콘텐츠가 실제로 발견되는지 확인하기
오늘 배운 내용을 자사몰의 실제 질문·페이지·발행 기록에 연결하세요.
Day 20. 발행한 콘텐츠가 실제로 발견되는지 확인하기
발행했다고 발견된 것은 아닙니다.
실무자가 알아야 할 이론적 배경
발행 완료와 발견 완료는 다릅니다
개념. 발행은 사용자가 공개 URL에서 콘텐츠를 볼 수 있는 상태이고, 발견·크롤링·색인은 검색 시스템의 별도 처리 상태입니다.
작동 원리. 새 URL은 200 응답, 보이는 본문, canonical, 내부 링크, sitemap 등 여러 경로로 발견 조건을 갖춥니다. 이후 처리 시점과 선택은 시스템에 달려 있어 즉시 노출을 약속할 수 없습니다.
왜 중요한가. CMS에서 공개 버튼을 누른 날짜를 성과 날짜로 쓰면 실제 검색 처리와 혼동합니다. 운영자는 통제 가능한 완료 조건과 외부 관찰을 분리해야 해요.
오늘의 실무 해석. 공개 URL·응답 상태·본문·canonical·내부 링크를 발행 체크로 남기고, Search Console의 발견·색인 관찰일은 다른 칸에 기록하세요.
이 설명의 근거: Search Console URL 검사 · 정본 근거 ID: T-05 · M-03
실제 사례에서는 어떻게 보였을까요?
Search Console · query와 URL의 노출·클릭을 같은 조건으로 비교해요
공식 화면 관찰. Search Console Performance 보고서는 클릭, 노출, CTR, 평균 게재순위를 query·page·country·device·date 등으로 나누어 보여줍니다.
공개된 관찰. 변경 URL로 page filter를 적용하고 같은 기간을 비교하면 어떤 query의 발견·클릭이 함께 변했는지 관찰할 수 있습니다.
그대로 일반화하면 안 되는 이유. 희소 query와 익명화 데이터는 보이지 않을 수 있고 평균 게재순위는 개인 검색 결과를 재현하지 않습니다. AI 서비스 전체 측정 도구도 아닙니다.
출처: Google Search Console Performance report · 자료 성격: 🟢 플랫폼 공식 문서
카페24 PRO · FAQ 운영 전후를 짧게 비교했어요
수치가 공개된 사례. 카페24 PRO가 고객사 FAQ 자동 등록 전후의 AI 유입과 주문 페이지 이동을 집계한 국내 사례입니다.
공개된 관찰. 23개 고객사 중 52%에서 AI 유입 증가를 보고했고, 일부 고객사의 FAQ에서 주문 페이지로 이어지는 이동도 증가했다고 발표했습니다.
그대로 일반화하면 안 되는 이유. 유료 기능 제공사의 자체 발표이고 표본이 작으며 전후 기간도 짧습니다. FAQ 자체의 인과 효과나 절대 수치를 일반화하지 않습니다.
출처: 카페24 PRO GEO 적용 사례 · 자료 성격: 🔴 플랫폼 자체 발표
오늘 이 사례에서 가져갈 판단 기준. CMS 공개 완료와 Search Console 발견·색인 관찰을 서로 다른 날짜와 상태로 기록합니다.
오늘의 근거를 2분만 같이 볼게요

근거 한 줄. 발행 완료와 발견 완료는 다릅니다. URL 상태, canonical, 마지막 crawl을 별도로 확인해야 합니다.
여기까지가 근거예요. URL 검사 화면은 실시간 전체 사이트 crawler나 AI 인용 확인기가 아닙니다.
| 글로벌 사례 | 국내 사례 |
|---|---|
| Shopify — sitemap과 공개 PDP 상태 확인 | 카페24·아임웹 — 실제 도메인의 발행 URL 상태 확인 |
오늘 우리 사이트에 적용할 한 가지. 발행 URL의 200·canonical·색인 상태를 기록합니다.
출처: Search Console URL 검사 · 정본 근거 ID: T-05 · M-03
오늘, 이 장면부터 같이 볼게요
어제 연결한 URL 하나를 브라우저에서 열어보세요. 잘 보이죠? 여기서 “그럼 검색과 AI도 읽겠네”라고 생각하기 쉬워요. 하지만 우리 브라우저에 보이는 것과 검색 시스템이 실제로 읽을 수 있는 것은 다른 문제입니다.
로그인한 관리자에게만 보이거나, JavaScript 실행 뒤에만 나타나거나, robots.txt·noindex·방화벽에 막힌 콘텐츠는 발행되어도 발견되지 않을 수 있어요. 오늘은 겁먹고 코드를 고치는 날이 아니라, 어느 단계에서 막혔는지 차분히 구분하는 날입니다.
Google은 AI 검색 기능을 위해 별도의 AI 전용 파일이나 특별한 구조화 데이터를 요구하지 않는다고 안내해요. 기본 조건은 페이지가 Google 검색에 색인되고 스니펫 표시 대상이 되는 것입니다. 중요한 정보는 텍스트로 제공하고, 내부 링크로 찾을 수 있게 하며, 구조화 데이터는 화면에 보이는 내용과 일치해야 해요. Google AI 검색 기능 안내
접근과 읽기를 화면으로 구분해볼까요?

출처: Google Search Central의 robots.txt 소개
이 화면은 접근 단계의 근거예요. robots.txt가 허용돼도 색인과 인용이 보장되는 것은 아니고, 민감한 정보를 보호하는 보안 장치도 아닙니다.
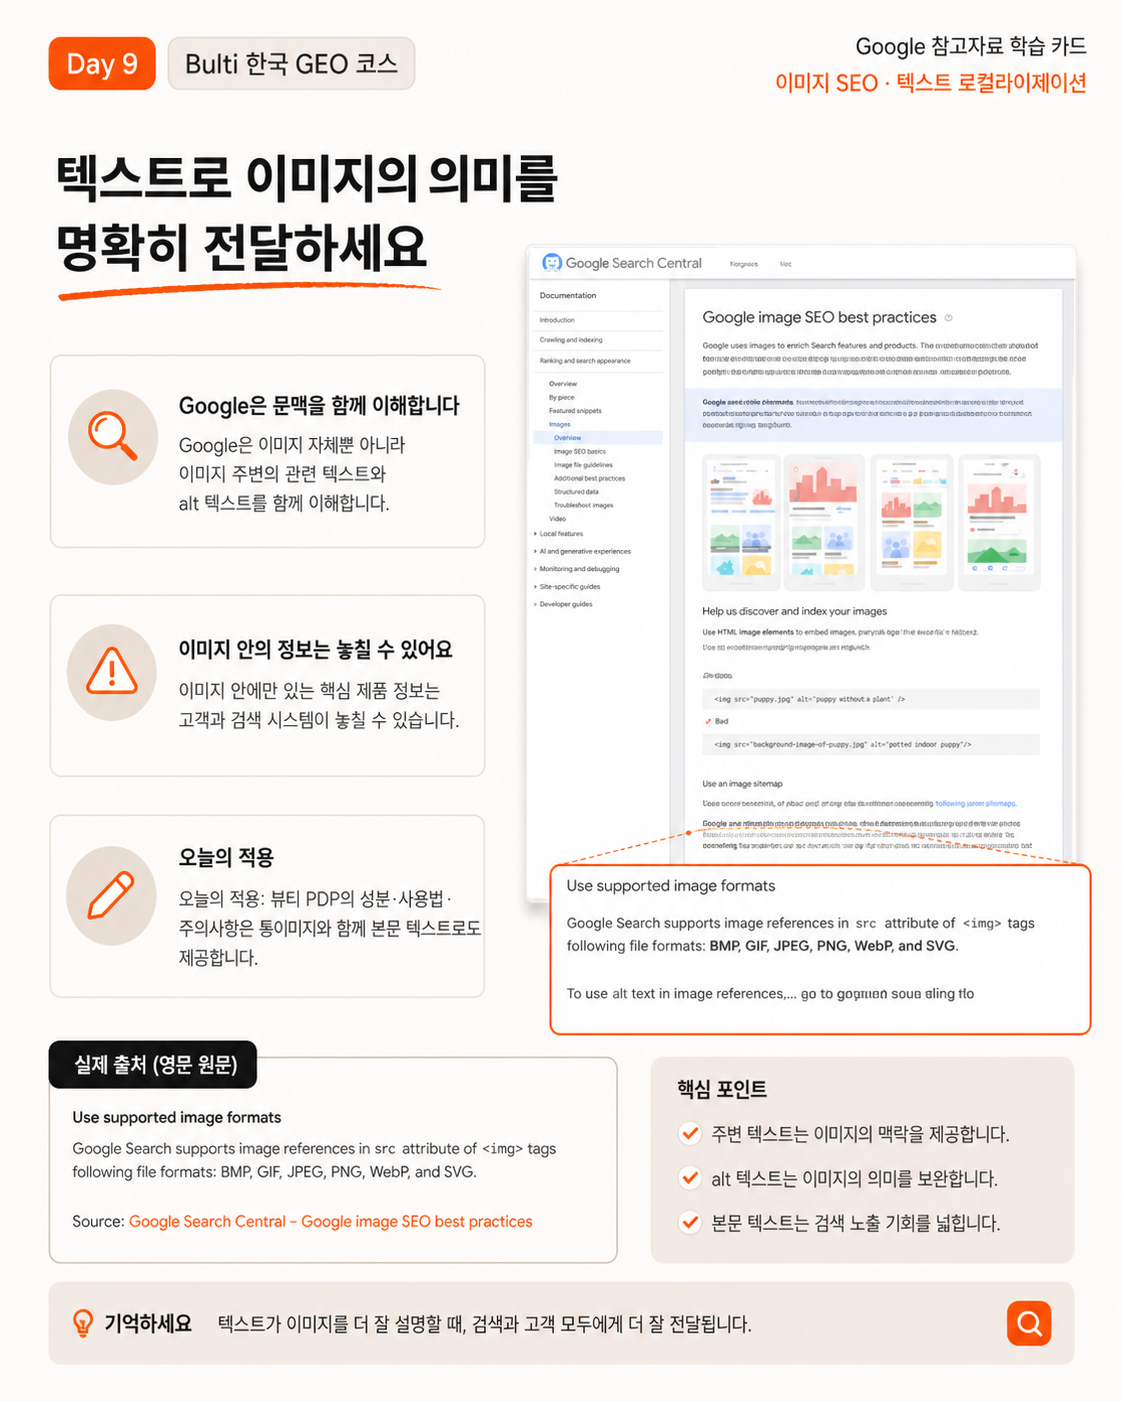
두 번째 화면은 읽기 단계와 연결돼요. 페이지 접근이 가능해도 핵심 답이 통이미지 안에만 있으면 제품·조건·근거를 안정적으로 연결하기 어려울 수 있습니다.
먼저 네 개의 문을 하나씩 통과해볼게요
| 단계 | 확인 질문 | 대표적인 문제 |
|---|---|---|
| 접근 | 로그인하지 않아도 URL이 열리는가 | 회원 전용, 국가·연령 팝업, WAF 차단 |
| 읽기 | 핵심 답변이 HTML 텍스트로 존재하는가 | 통 이미지, JavaScript 렌더링 실패 |
| 색인 | 검색 엔진이 수집·색인할 수 있는가 | robots.txt, noindex, 잘못된 canonical |
| 인용 후보 | 질문에 대한 직접 답과 출처가 있는가 | 제품 홍보만 있고 답변이 없음 |
색인됐다고 AI 답변에 반드시 인용되는 것은 아니에요. 반대로 아직 인용되지 않았다고 기술 오류라고 단정할 수도 없어요. 오늘은 성과를 판단하기 전에 먼저 발견되고 읽힐 수 있는 상태인지 확인할게요.
“AI 봇 허용” 하나로 끝나지 않는 이유가 있어요
| 서비스 | 확인할 크롤러 | 역할 |
|---|---|---|
| Googlebot | 일반 검색과 Google AI 기능의 검색 기반 수집 | |
| OpenAI | OAI-SearchBot | ChatGPT 검색 결과에 사이트가 나타나는 것과 관련 |
| OpenAI | GPTBot | 모델 학습 관련 제어로 검색 노출용 봇과 별개 |
| Perplexity | PerplexityBot | Perplexity 검색 결과용 콘텐츠 수집 |
OpenAI는 OAI-SearchBot과 GPTBot을 독립적으로 제어할 수 있다고 설명해요. OpenAI 크롤러 안내 Perplexity는 방화벽에서 사용자 에이전트뿐 아니라 공식 IP 범위가 필요한 경우도 안내해요. Perplexity 크롤러 안내
robots.txt에 허용 문구가 있어도 CDN이나 WAF가 실제 요청을 차단할 수 있어요. robots.txt가 정상이다를 최종 결론으로 사용하지 마세요.
어제 발행한 URL로 30분 점검을 같이 시작할게요
1. 로그아웃 상태로 열기
시크릿 창 또는 로그아웃한 브라우저에서 가이드·PDP·FAQ를 엽니다. 팝업을 닫지 않아도 본문 접근이 가능한지, 모바일에서도 핵심 답변이 보이는지 확인해요.
2. 화면의 문장을 페이지에서 검색하기
킬링 문장과 첫 답변의 일부를 브라우저 페이지에서 찾기로 검색해요. 이미지 속에만 있거나 복사할 수 없다면 HTML 텍스트로 추가해요.
3. Google Search Console URL 검사
Google Search Console의 URL 검사에서 색인 허용 여부, Google이 선택한 canonical, 마지막 크롤링 상태를 확인해요. 새 URL은 색인 생성 요청을 할 수 있지만 즉시 색인이나 순위를 보장하지 않아요.
4. 국내 검색도 별도로 확인하기
Naver Search Advisor에서 사이트 소유 확인, 수집 상태, 구조화 데이터와 IndexNow 안내를 확인해요. Google에 등록됐다고 Naver 상태까지 자동으로 확인되는 것은 아닙니다.
발견 가능성 점검표
| URL | 공개 접근 | 텍스트 확인 | robots/noindex | canonical | Naver | AI 봇/WAF | 조치 | |
|---|---|---|---|---|---|---|---|---|
[가이드] |
정상/문제 |
정상/문제 |
정상/문제 |
[URL] |
[상태] |
[상태] |
[확인/미확인] |
[할 일] |
오늘은 여기까지 실제로 발행해볼게요
점검 중 텍스트가 약한 URL 두 곳에 다음 답변 블록을 추가해요.
[고객 질문]
[2~4문장의 직접 답변]
[예외 또는 확인 조건]
[관련 공식 페이지 링크]
기술 점검만 하고 콘텐츠 생산을 멈추지 않아요.
여기까지 했다면, 오늘은 충분해요
- 가이드·PDP·FAQ를 로그아웃 상태에서 열었다.
- 핵심 답변이 복사 가능한 텍스트인지 확인했다.
- Google과 Naver의 수집 상태를 확인했다.
- robots.txt와 WAF를 서로 다른 문제로 구분했다.
- URL 두 곳에 답변 블록을 추가했다.
여기까지 했다면 이제 검색에 안 나와요라는 문제를 하나로 뭉뚱그리지 않고, 접근·텍스트·색인·답변 중 어디를 봐야 하는지 구분할 수 있어요.
내일은 이런 게 궁금해질 거예요
발견 가능한 상태까지 확인했어요. 그런데 다음 달에 숫자가 움직였을 때 “그때 우리가 뭘 바꿨지?”가 기억나지 않으면 곤란하겠죠? 내일은 변경 기록을 남겨볼게요.